TL;DR
후보 중 정답이 존재하는 것과 그 정답을 골라 전달하는 것은 다르며, 검증기의 정확도가 추론 시 계산 확장의 성과를 결정한다.
ORM은 최종 결과를, PRM은 중간 추론 단계를 평가한다. 과정 감독은 더 세밀한 피드백을 주지만 라벨 수집 비용과 잘못된 보상 신호를 함께 다뤄야 한다.
자동 과정 라벨링과 약한 검증기의 가중 결합은 검증을 확장하는 방법이며, 그 판단을 작은 모델로 증류하거나 강화 학습에 활용하면 비용 절감과 자기 개선으로 이어진다.
Stanford CS329A: Self-Improving AI Agents의 3강은 “여러 후보 중 어떤 답이 맞는지 어떻게 알아낼까?”를 다룬다. 2강의 추론 시 계산 확장을 실제 성과로 연결하는 검증(verification)에 집중한다.
강사: Azalia Mirhoseini · 강의일: 2025년 9월 29일 · 원본 영상
강의·영상 속 슬라이드·원 논문을 바탕으로 정리한 학습 노트다. 모델 비교와 실험 수치는 강의 당시의 연구 조건을 뜻한다.
1. 출발점: 정답을 생성하는 능력과 고르는 능력은 다르다
같은 문제를 여러 번 풀게 하면 한 번의 응답에 드러나지 않았던 해결 능력을 끌어낼 수 있다. 하지만 후보 100개 안에 정답이 하나 있다는 사실만으로 사용자가 그 정답을 받는 것은 아니다. 정답 후보를 만드는 능력과, 그 후보를 찾아내는 능력 사이의 차이가 generation–verification gap이다.
이를 평가할 때 pass@K는 K개 후보 중 정답이 하나라도 존재하는지를 본다. 정답을 정확히 식별하는 이상적인 선택기인 oracle가 도달할 수 있는 성능의 상한에 가깝다. 실제 시스템의 성능은 검증기나 투표를 거쳐 최종적으로 선택한 답이 맞는지로 판단해야 한다.
가장 단순한 기준선은 다수결(majority voting), 또는 self-consistency다. 풀이가 달라도 최종 답을 기준으로 묶고, 가장 자주 나온 답을 고른다. 추가 보상 모델이 필요 없지만, 자주 반복되는 오답을 선택할 수도 있다. 풀이의 타당성을 직접 검증하는 방식은 아니다. [00:05–01:10] [33:26–33:49]
2. 학습된 검증기: 여러 풀이를 만들고, 맞을 확률을 평가한다
첫 논문인 Training Verifiers to Solve Math Word Problems(2021)는 GSM8K를 소개했다. 약 8,500개의 초등 수준 수학 문장제로 구성되며, 개념 자체보다 여러 단계의 추론을 일관되게 연결하는 능력을 시험한다. 자연어 풀이로 문제 해석과 중간 과정도 살펴볼 수 있다.
핵심은 생성기와 검증기의 역할을 나누는 것이다.
- 생성기 준비: 문제와 풀이 데이터로 생성기를 미세 조정한다.
- 검증용 데이터 생성: 학습 문제마다 100개의 후보 풀이를 만들고, 최종 답을 이미 알고 있는 정답과 비교해 정오 라벨을 붙인다.
- 검증기 학습: 문제와 후보 풀이를 입력받아 해당 풀이가 맞을 확률을 예측하도록 별도 모델을 학습한다.
- 추론 시 선택: 새 문제에서도 여러 풀이를 생성한 뒤 검증 점수가 가장 높은 것을 최종 답으로 출력한다.
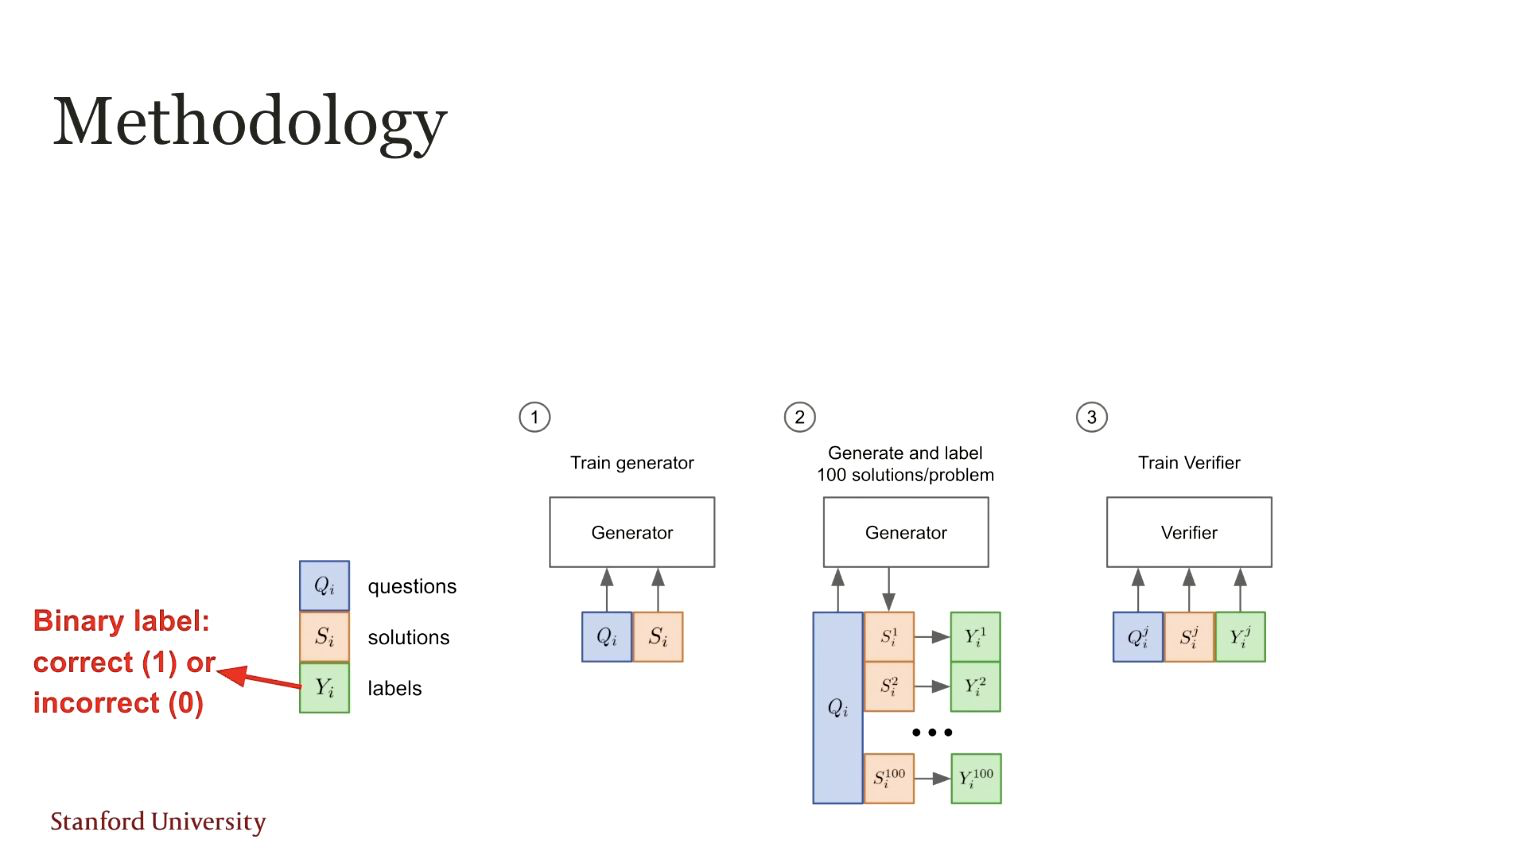
그림 1. 여러 후보를 정오 라벨로 학습하고 검증 점수로 선택하는 흐름. 출처: Stanford CS329A 3강, 04:41. 원 연구: Cobbe et al., 2021.
실험에서는 충분한 검증 데이터가 있을 때 단순 미세 조정만 하는 방식보다 좋은 결과를 보였다. 또 큰 생성기와 작은 검증기를 결합하는 쪽이 반대 조합보다 유리했다. 모든 모델에서 동일한 자원 배분이 최적이라는 뜻은 아니다.
중요한 한계도 있다. 후보를 늘릴수록 검증기를 속이는 고득점 오답을 만날 위험이 커진다. 이 논문의 실험에서는 약 400개 이후 선택 정확도가 떨어졌고, 기본 설정은 이득과 비용을 고려해 100개를 사용했다. 후보의 수와 최종 선택의 정확도는 분리해서 봐야 한다. 400이라는 숫자는 보편적인 한계가 아니라 특정 실험의 결과다. [12:53–18:24]
3. ORM과 PRM: 결과만 평가할까, 과정도 평가할까?
두 번째 논문인 Let's Verify Step by Step(2023)는 보상 모델에 어떤 감독 신호를 줄 것인지 비교한다.
| 구분 | Outcome Reward Model(ORM) | Process Reward Model(PRM) |
| 감독 대상 | 최종 결과의 정오 | 각 중간 추론 단계의 타당성 |
| 학습 신호 | 풀이 전체가 맞았는지 | 어느 단계까지 맞고 어디서 틀렸는지 |
| 주요 장점 | 정답 확인이 쉬운 과제에서 라벨을 자동 생성하기 좋다. | 오류 위치를 알려 더 구체적인 피드백을 준다. |
| 주요 부담 | 우연히 정답에 도달한 잘못된 풀이도 맞다고 라벨링할 수 있다. | 단계별 평가 데이터를 수집하고 평가 기준을 정해야 한다. |
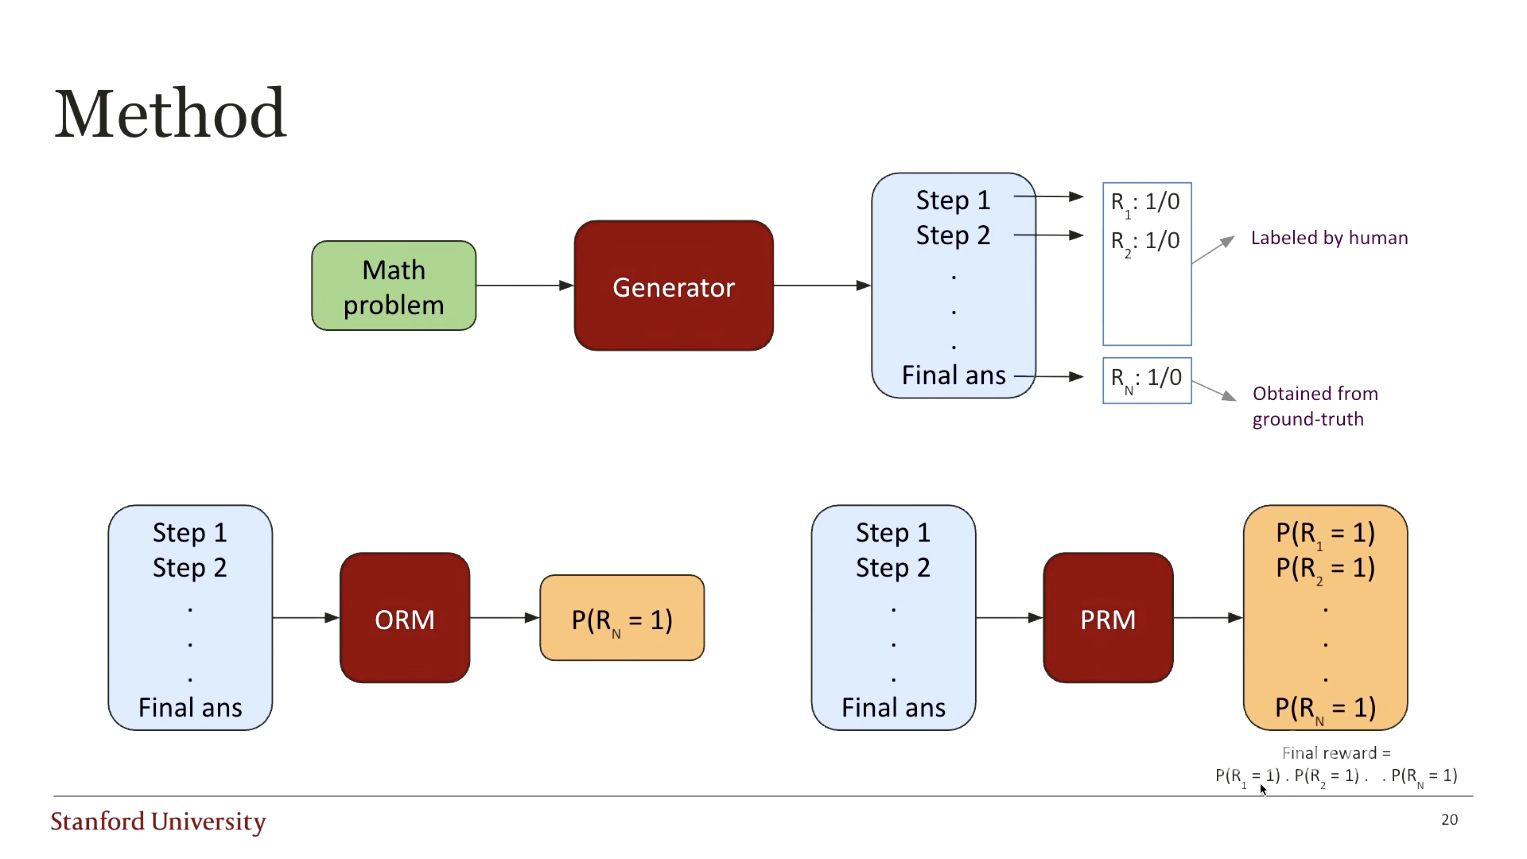
그림 2. 최종 결과를 감독하는 ORM과 단계별 과정을 감독하는 PRM. 출처: Stanford CS329A 3강, 24:05, 슬라이드 20. 원 연구: Lightman et al., 2023.
결과만 틀렸다고 알려주면 모델은 긴 풀이의 어느 부분이 문제였는지 알아내야 한다. PRM은 오류의 위치를 직접 알려주므로 어떤 단계에 책임을 돌릴지 정하는 문제(credit assignment)를 줄인다. 원 논문은 단계별 올바름의 확률을 곱해 풀이의 점수로 사용했다. 다른 PRM은 다른 집계 방식을 쓸 수 있다.
이 연구에서 공개한 PRM800K는 약 80만 개의 사람 평가 라벨이다. 문제 80만 개를 뜻하지 않으며, 각 단계에 positive·negative·neutral을 붙였다. 또 검증기 점수는 높지만 최종 답은 틀린 ‘그럴듯한 오답’을 우선 사람에게 보여주는 능동 학습으로 수집 효율을 높였다.
실험에서는 PRM이 ORM과 다수결보다 좋은 선택 성능을 보였다. 다만 이 논문은 고정된 생성기의 후보를 더 잘 고르는 검증기를 연구했으며, 생성기를 강화 학습으로 개선한 결과는 아니다. 과정 감독이 수학에서 효과적이라는 사실을 모든 분야로 일반화할 수도 없다. 강의는 ORM과 PRM의 결합, 추가 임계값 조정, 보상을 이용한 학습에서의 악용 가능성도 함께 논의한다. [21:18–37:43]
4. Math-Shepherd: 사람 대신 후속 풀이로 단계의 가치를 추정한다
Math-Shepherd는 PRM의 단계별 라벨을 사람이 모두 붙여야 하는 비용 문제를 다룬다. 중간 풀이까지 주어진 상태에서 모델이 여러 후속 풀이를 끝까지 생성하게 하고, 그 결과를 이미 알고 있는 최종 정답과 비교한다. 여기서 단계의 품질은 ‘이 상태에서 정답에 도달할 가능성’으로 정의된다.
- Hard Estimation: N개 후속 풀이 중 하나라도 정답에 도달하면 해당 단계에 1, 모두 실패하면 0을 준다.
- Soft Estimation: N개 중 정답에 도달한 비율을 점수로 쓴다. 3개 중 2개가 성공했다면 2/3이다.
이 방법으로 만든 데이터로 PRM을 학습하면 두 가지에 사용할 수 있다. 첫째, 추론 시 여러 후보를 재평가해 답을 고른다. 둘째, 단계별 점수를 PPO 강화 학습의 보상으로 사용해 생성기 자체를 개선한다. 검증 신호가 다음 모델의 학습으로 이어지는 것이다.
그러나 후속 풀이의 성공 가능성은 그 단계가 논리적으로 완벽하다는 증명이 아니다. 샘플이 적으면 드물지만 올바른 경로를 놓쳐 0점을 줄 수 있고, 어려운 문제에서는 모든 후속 풀이가 실패해 유용한 신호가 사라진다. 중간에 오류가 있어도 우연히 정답에 도달하면 잘못된 단계를 좋게 평가할 수 있다. ‘사람의 단계별 주석 없이’라는 뜻이지, 문제와 최종 정답까지 전혀 필요 없다는 뜻은 아니다.
성능을 읽을 때는 강화 학습 후 한 번 답한 결과와 여러 후보를 추가 생성·검증한 결과를 구분해야 한다. 생성과 검증에 계산 예산을 어떻게 나눌지, 비교 실험의 데이터와 비용을 어떻게 맞출지 역시 열린 문제다. [37:48–51:40]
5. Weaver: 완벽하지 않은 검증기 여러 개를 더 잘 결합하기
마지막 논문인 Shrinking the Generation-Verification Gap with Weak Verifiers(2025)의 Weaver는 새로운 검증기 하나를 학습하는 대신, 이미 존재하는 여러 보상 모델과 LLM 평가자를 결합한다. 여기서 ‘약한’ 검증기는 유용한 신호는 있지만 완벽하지 않은 검증기를 뜻한다.
단순 평균만으로는 충분하지 않다. 검증기마다 정확도가 다르고, 출력이 이진 판단·연속 점수 등 서로 다른 척도일 수 있다. 잘못된 판단을 많이 하는 검증기를 같은 비중으로 더하면 오히려 성능을 떨어뜨릴 수도 있다. Weaver의 흐름은 다음과 같다.
- Score: 각 후보를 여러 검증기로 평가하고 점수를 정규화한다. 품질이 낮은 검증기는 제거한다.
- Weight: 약한 감독(weak supervision)으로 검증기들의 정확도와 가중치를 추정한다.
- Select: 가중 결합한 점수로 후보를 평가하고 최종 답을 선택한다.
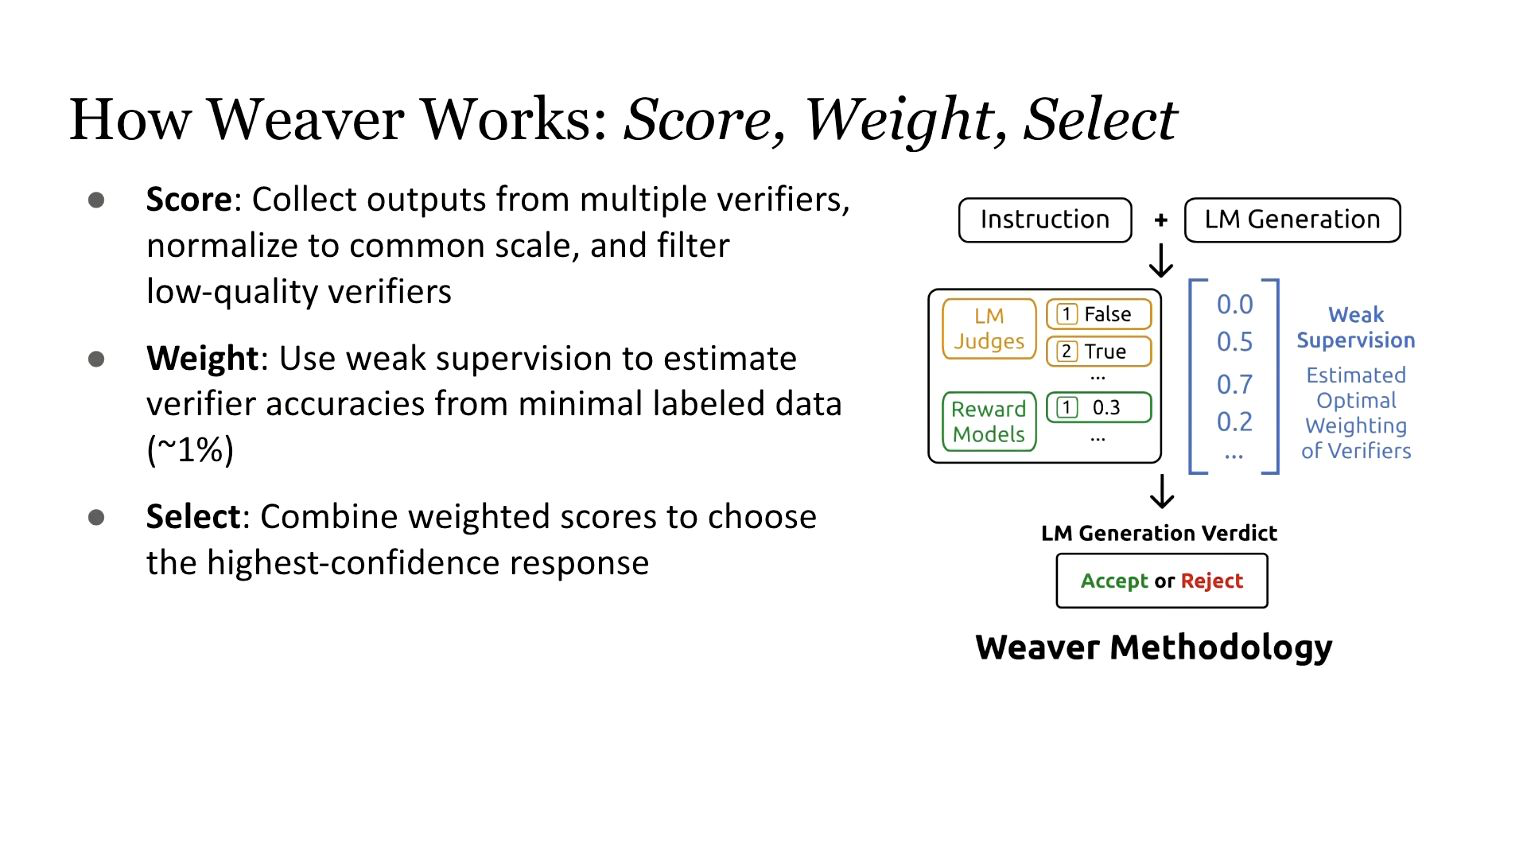
그림 3. 약한 검증기들의 점수를 결합하는 Weaver. 출처: Stanford CS329A 3강, 56:05. 원 연구: Saad-Falcon et al., 2025.
중요한 조건은 검증기들이 서로 보완적인 정보를 주어야 한다는 점이다. 강의는 독립성을 핵심 가정으로 설명한다. 검증기들이 같은 편향을 공유하면, 판단이 일치해도 정답이 보장되지 않는다. 또 강의의 ‘unsupervised’ 비교에서도 검증기 필터링 등을 위해 훈련 라벨의 1%를 사용했다고 설명하므로, 아무 라벨도 전혀 필요 없는 방식으로 이해하면 부정확하다.
실험에서는 단순 다수결이나 평균 앙상블보다 실제 최종 선택의 정확도를 높이며 생성–검증 간극을 줄였다. 작은 모델과 큰 모델의 성능 차이를 좁힌 사례도 있지만, 특정 벤치마크에서 생성·검증 비용을 추가한 결과다. 모든 작업에서의 대체 가능성을 뜻하지 않는다. [51:47–1:04:14]
6. 검증의 비용을 낮추고, 그 판단으로 다음 모델을 개선한다
앙상블은 후보마다 여러 검증기를 실행해야 하므로 후보 수와 검증기 수가 늘면 비싸진다. Weaver는 이 문제에 대해 큰 검증기 집단의 판단을 약 4억 파라미터의 작은 cross-encoder로 증류하는 방법을 소개한다. 큰 앙상블의 성능을 대부분 유지하면서 검증에 필요한 추론 계산을 크게 줄였다. 이 절감 효과를 생성기까지 포함한 전체 서비스 비용의 절감률로 읽어서는 안 된다.
네 논문을 연결하면 자기 개선의 구조가 보인다.
후보 풀이 생성 → 결과 또는 과정 검증 → 좋은 풀이와 보상 신호 확보 → 생성기·검증기 학습 또는 증류 → 더 나은 다음 시도
이때 현재 실행에서 더 좋은 답을 고르는 것과 그 결과로 모델 가중치를 바꾸는 것은 다른 단계다. Math-Shepherd의 강화 학습이나 Weaver의 증류는 검증 신호를 학습으로 다시 연결하는 구체적인 방법이다.
강의 말미는 한 번의 응답만으로 성공하는 pass@1을 높이면 효율이 좋아진다는 점과, 특정 답에 지나치게 확률이 몰리면 다양한 해결 경로를 탐색하는 능력을 잃을 수 있다는 점을 함께 짚는다. 선택의 정확도, 검증 비용, 생성의 다양성을 함께 보존하는 것이 중요하다. [1:04:18–1:11:44]
이 강의에서 가져갈 관점
에이전트가 더 오래 생각하거나 더 많은 답을 만들게 하는 것만으로 신뢰성이 완성되지는 않는다. 먼저 성공을 어떤 신호로 판정할 수 있는지를 정하고, 그 신호가 결과 전체에만 있는지 중간 단계에도 있는지 확인해야 한다. 이어서 검증기가 놓치는 오류와, 늘어난 후보 속에서 고득점 오답을 선택할 가능성을 점검해야 한다.
실험에서는 후보 수에 따른 pass@K와 최종 선택 정확도를 따로 보고, 생성과 검증을 합친 비용도 기록하는 편이 좋다. ORM·PRM·실행 테스트·LLM 평가 등 사용할 수 있는 피드백을 비교하고 필요에 따라 결합한다. 좋은 검증기는 답을 고르는 도구인 동시에, 다음 모델이 무엇을 배워야 하는지 알려주는 학습 신호다.
출처 및 슬라이드 인용
· Stanford Online — CS329A Part 3: Robust Verification
· Stanford CS329A 공식 강의 일정·읽기 자료
· Cobbe et al. — Training Verifiers to Solve Math Word Problems
· Lightman et al. — Let's Verify Step by Step
· Wang et al. — Math-Shepherd
· Saad-Falcon et al. — Shrinking the Generation-Verification Gap with Weak Verifiers(강의 당시 판본)
슬라이드 이미지는 원본 강의 영상의 해당 화면을 발췌하고 각 그림 아래에 출처와 시점을 표기했다. 본문은 원문의 직역이 아닌 요약·해설이다.
'AI Agent, LLM > Stanford CS329A Self Improving AI Agents' 카테고리의 다른 글
| [Stanford CS329A] 2강. 추론 시 계산 확장: 반복 생성·검증·탐색으로 더 좋은 답 얻기 (0) | 2026.11.12 |
|---|---|
| [Stanford CS329A] 1강. LLM에서 자기 개선 AI 에이전트로: 스케일링·추론·검증 (0) | 2026.11.12 |