TL;DR
학습 시 계산 확장은 모델이 만든 풀이를 검증·선별해 다시 학습시키며, 현재의 성공 경험을 다음 응답의 성능으로 연결한다.
STaR는 정답으로 이어진 추론을 재학습하고, DeepSeekMath의 GRPO는 같은 문제에서 생성한 답들의 상대적 보상으로 모델을 개선한다.
긴 추론을 강화 학습하려면 DAPO처럼 탐색의 다양성, 유효한 보상 차이, 토큰별 손실, 길이 제한으로 생기는 잡음을 함께 관리해야 한다.
Stanford CS329A: Self-Improving AI Agents의 공개 영상 6강은 Train Time Scaling / Scaling RL을 다룬다. 앞선 강의가 더 많은 후보와 도구 피드백으로 현재 문제를 푸는 법을 살폈다면, 이번에는 그 결과를 학습에 돌려 모델 자체를 개선하는 순환을 완성한다.
Stanford Online 원본 영상 · 공개 영상 Part 6 기준
강의·영상 속 슬라이드·원 논문을 바탕으로 정리한 학습 노트다. 실험 결과는 당시의 모델·데이터·평가 조건을 뜻하며, 서로 다른 벤치마크의 숫자를 직접 비교하지 않는다.
1. 추론에 쓴 계산을 다음 모델의 학습으로 연결한다
추론 시 계산 확장(test-time scaling)은 이미 학습된 모델로 여러 답을 만들고, 검증하거나 수정해 이번 문제의 답을 고른다. 반면 이번 강의의 학습 시 계산 확장(train-time scaling)은 그렇게 얻은 출력과 피드백으로 가중치를 업데이트한다. 두 방식은 대체 관계만 있는 것이 아니라 함께 작동한다.
문제 → 후보 풀이 생성 → 정답·보상으로 평가 → 좋은 행동을 학습 → 개선된 모델로 다시 생성
핵심은 출력의 양보다 어떤 출력을 학습에 사용할지다. 수학의 정답 비교나 코드의 테스트처럼 검증 가능한 신호가 있으면 이 순환을 만들기 쉽다. 틀린 풀이를 그대로 재학습하면 오류를 강화할 수 있고, 아무 문제도 풀지 못하는 모델이라면 성공 사례를 얻는 것부터 막힌다. 기초 모델의 능력과 검증기의 품질이 출발 조건이다. [03:13–07:35]
2. STaR: 스스로 만든 추론을 골라 배우기
STaR(Self-Taught Reasoner)는 대규모의 사람이 쓴 풀이 대신, 소수의 추론 예시와 정답이 있는 문제 집합을 활용한다. 모델이 풀이를 생성하게 하고, 최종 답이 맞은 것들을 모아 미세 조정한 뒤 이 과정을 반복한다.
- 생성: 몇 개의 문제·풀이·정답 예시를 보여 주고 새로운 학습 문제의 추론과 답을 만들게 한다.
- 선별: 최종 답을 알려진 정답과 비교해 성공한 추론을 모은다.
- 합리화(rationalization): 실패한 문제에는 정답을 힌트로 주고, 그 답으로 이어지는 풀이를 다시 생성하게 한다.
- 재학습: 성공한 풀이들과 합리화로 얻은 풀이들을 학습한다. 이때 입력에서 정답 힌트를 제거해, 다음에는 문제만 보고 풀도록 한다.
- 반복: 개선된 모델로 다시 풀이를 만들고 학습 데이터를 갱신한다.
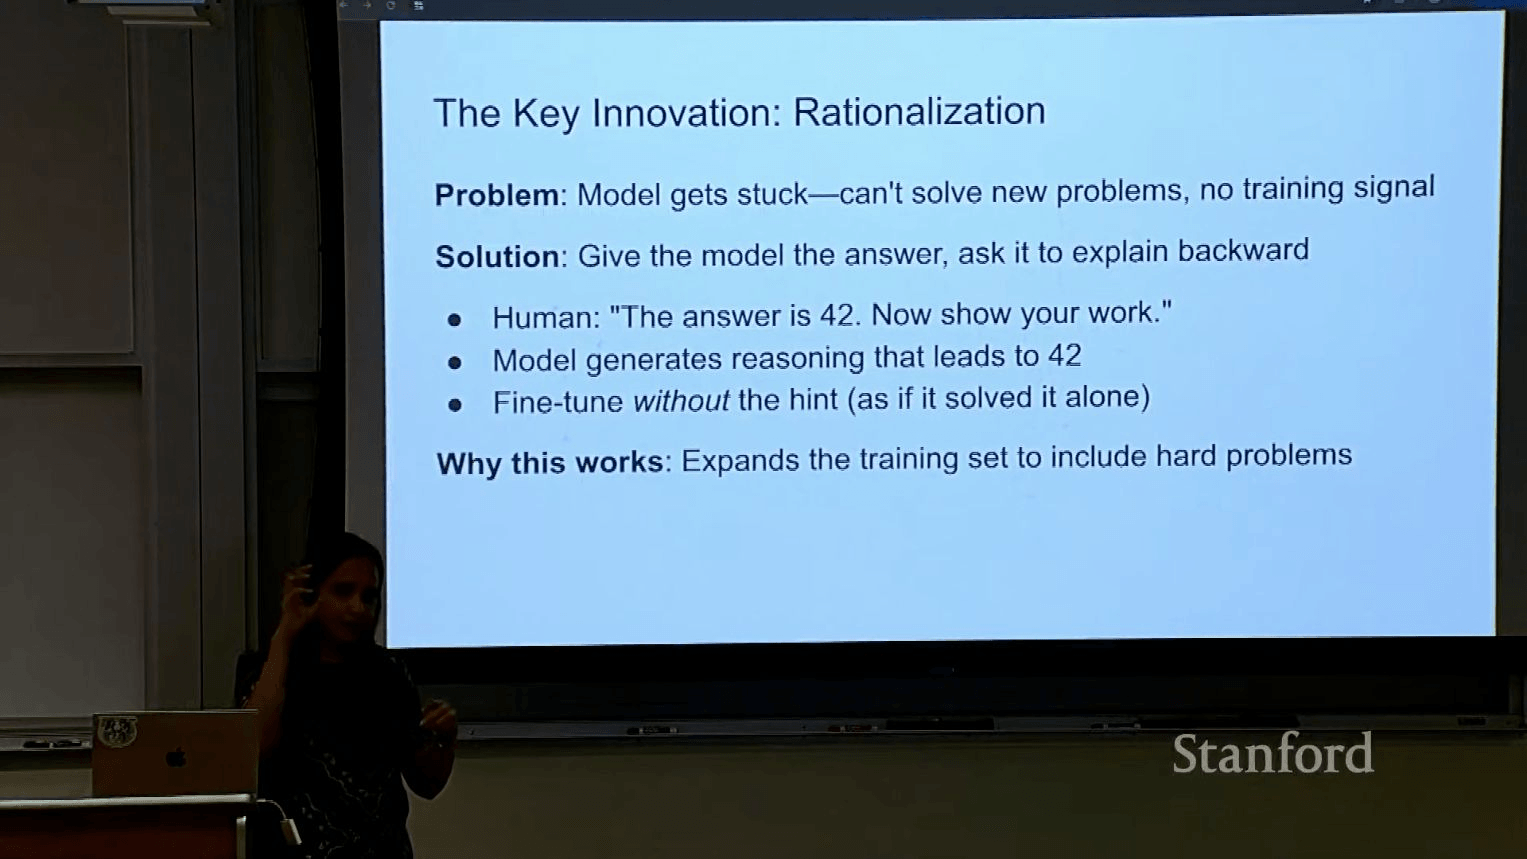
그림 1. 정답을 힌트로 풀이를 만든 뒤, 힌트 없이 학습하는 STaR의 rationalization. 출처: Stanford CS329A 공개 영상 6강, 19:09. 원 연구: Zelikman et al., 2022.
정답을 이미 알고 있다는 조건이 중요하다. STaR는 아무 감독 없이 지식을 무한히 만들어 내는 방식이 아니다. 힌트는 처음에는 풀지 못했던 문제에서도 학습용 추론을 얻도록 돕지만, 모델이 힌트를 받아도 타당한 풀이를 만들 수 있어야 한다.
또 정답이 맞다는 사실이 중간 추론 전체의 타당성을 보장하지 않는다. 결과에 맞춰 그럴듯한 설명을 꾸밀 수 있고, 처음 보여 준 예시의 형식에 편향될 수도 있다. 강의는 이 한계와 과정 검증의 필요성을 함께 짚는다. 강한 외부 모델의 풀이를 작은 모델에 학습시키는 증류와도 구분해야 한다. STaR의 초점은 자기 모델이 생성한 추론을 이용하는 데 있다. [16:08–33:50]
3. DeepSeekMath와 GRPO: 같은 문제의 답들을 상대 평가한다
DeepSeekMath는 강화 학습 알고리즘 하나만의 성과가 아니다. 코드 기반 모델을 출발점으로 수학 웹 데이터를 선별해 추가 사전 학습하고, 지시 데이터로 미세 조정한 뒤 강화 학습을 적용했다. 좋은 기초 모델과 데이터가 있어야 보상으로 더 나은 행동을 끌어낼 수 있다.
강화 학습의 핵심인 GRPO(Group Relative Policy Optimization)는 별도의 critic, 즉 가치 추정 모델을 학습하는 부담을 줄인다. 하나의 문제에 대해 여러 답을 생성하고, 각 답의 보상을 그룹 안에서 비교해 어떤 응답을 더 강화할지 정한다.
단순화한 advantage = (각 답의 보상 − 그룹 평균 보상) ÷ 그룹 보상의 표준편차
같은 문제에서 평균보다 좋은 답은 더 자주 나오도록, 상대적으로 나쁜 답은 덜 나오도록 학습하는 것이다. 이 식은 좋고 나쁨을 비교하는 신호를 설명한 것이며, 실제 학습에는 정책 변화의 제한 등 추가 항이 들어간다. critic이 없다는 뜻이 보상 평가까지 없어진다는 뜻은 아니다.
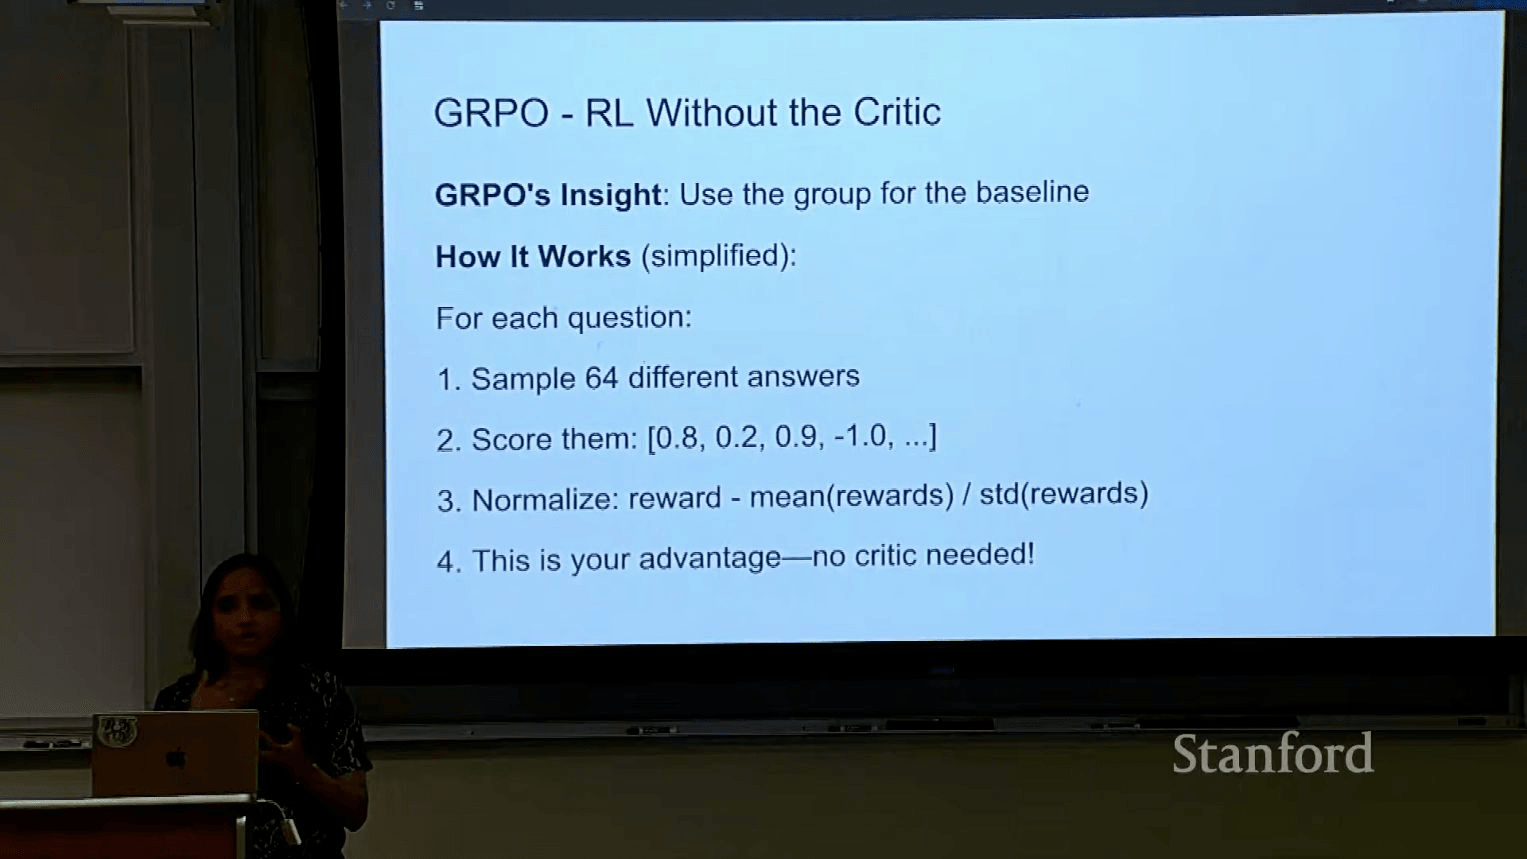
그림 2. 별도 critic 대신 답변 그룹을 기준선으로 쓰는 GRPO의 직관. 출처: Stanford CS329A 공개 영상 6강, 45:27. 원 연구: Shao et al., 2024. 위 본문의 식은 괄호를 명시해 정리했다.
DeepSeekMath 논문의 51.7%는 MATH 벤치마크의 결과다. DAPO의 AIME 2024 점수와 같은 시험이 아니다. 학습 전후의 개선을 볼 때도 모델 크기, 도구 사용, 투표 여부를 맞춰 읽어야 한다. [40:53–47:42]
4. DAPO: 긴 추론의 강화 학습은 작은 구현 차이에 민감하다
GRPO를 더 큰 모델과 긴 추론에 그대로 적용한다고 안정적으로 좋아지지는 않는다. 답이 한 가지 패턴으로 쏠리는 탐색 다양성의 붕괴, 보상 잡음, 응답 길이의 급증이 생길 수 있다. DAPO는 이 문제를 네 가지 장치로 다룬다.
- Clip-Higher: 정책 확률의 증가와 감소를 제한하는 범위를 분리한다. 증가 쪽 여유를 더 줘, 드물지만 유용한 행동을 탐색할 가능성이 너무 빨리 사라지는 것을 막는다.
- Dynamic Sampling: 한 문제의 답들이 전부 정답이거나 전부 오답이면 그룹 안의 보상 차이가 없어 학습 신호가 약하다. 이런 그룹을 제외하고 추가 생성해, 성공과 실패가 섞인 문제들로 유효한 배치를 채운다.
- Token-Level Policy Gradient Loss: 각 응답을 따로 평균낸 뒤 같은 비중으로 합치는 대신, 전체 토큰 단위로 손실을 집계한다. 긴 응답 안의 유용한 추론과 반복·잡음 패턴도 길이에 묻히지 않고 학습에 반영한다. 단순히 긴 답에 벌점을 주는 규칙은 아니다.
- Overlong Reward Shaping: 최대 길이에 걸려 잘린 답을 무조건 틀린 추론처럼 벌주면 신호가 오염된다. 잘린 샘플의 손실을 제외하는 실험과 길이 초과에 대한 완만한 벌점을 통해 이 잡음을 줄인다.
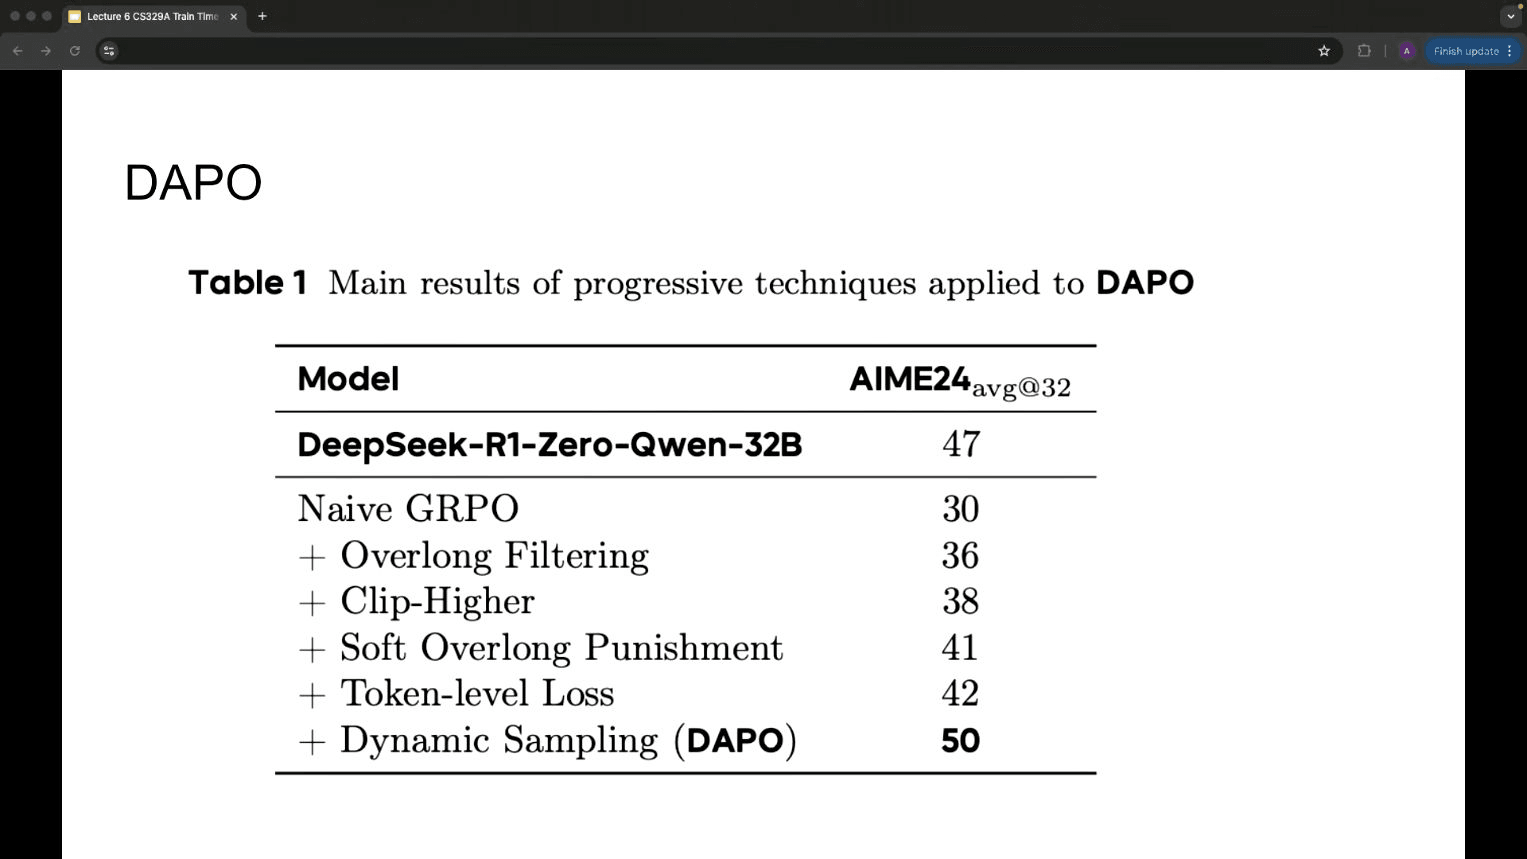
그림 3. DAPO 구성 요소를 차례로 더했을 때의 AIME 2024 결과. 출처: Stanford CS329A 공개 영상 6강, 59:59. 원 연구: Yu et al., 2025.
해당 실험에서 Qwen2.5-32B 기반의 단순 GRPO 설정은 30점, 개선을 합친 DAPO는 50점이었다. 이는 AIME 2024를 32회 반복 평가해 평균낸 avg@32이며, 후보 32개 중 하나만 맞으면 성공으로 세는 pass@32와 다르다. 표의 증가폭도 각 장치의 보편적인 효과 크기를 뜻하지 않는다. [53:06–1:01:10]
5. 더 자주 맞는 것과 새로운 문제를 풀 수 있는 것은 다르다
Maj@K는 K개 답 중 다수결로 고른 답이 맞는지를 본다. Pass@K는 그 안에 정답이 하나라도 있는지를 본다. 전자는 정답에 확률이 얼마나 안정적으로 모이는지, 후자는 생성할 수 있는 해결 경로의 범위를 살피는 데 도움이 된다.
DeepSeekMath의 해당 실험에서는 RL 이후 Maj@K는 좋아졌지만 Pass@K는 뚜렷하게 좋아지지 않았다. 강의는 이를 이미 가능한 정답을 더 일관되게 내는 개선과 풀 수 있는 문제 범위의 확장을 구분해야 한다는 근거로 다룬다. 이것을 모든 RL이 새로운 능력을 만들 수 없다는 일반 법칙으로 읽어서는 안 된다.
같은 이유로 자연어 추론에 “잠깐”, “다시 생각하자”가 나타난다고 실제로 신뢰할 만한 자기 교정이 생겼다고 단정할 수 없다. 결과 지표와 함께 검증해야 한다. 학습은 보상을 높이는 방향으로 진행되므로, 불완전한 보상 기준의 빈틈을 파고드는 reward hacking도 경계해야 한다. [52:19–53:02] [1:03:12–1:07:54]
6. 방법 선택은 데이터·보상·학습 기반에 달려 있다
| 접근 | 주로 필요한 조건 | 먼저 볼 지점 |
| STaR | 소수의 풀이 예시, 정답이 있는 문제, 미세 조정 환경 | 생성한 풀이의 타당성과 반복 학습의 정체 |
| GRPO | 적절한 기초 모델, 신뢰할 보상, 여러 응답 생성과 RL 환경 | 그룹 안의 보상 차이와 메모리·생성 비용 |
| DAPO | 긴 추론을 대규모로 학습·추적할 기반 | 탐색 다양성, 유효 배치, 토큰 손실, 길이 제한의 잡음 |
강의의 실용적인 메시지는 RL의 손실값 하나만으로 학습 상태를 판단하지 말라는 것이다. 검증 정확도와 보상뿐 아니라 응답 길이, 생성 분포의 다양성을 나타내는 엔트로피, 전부 맞거나 전부 틀린 그룹의 비율을 함께 추적해야 한다. 슬라이드의 특정 임계값은 해당 실험의 예시로 보아야 한다. [1:00:17–1:03:04]
이 강의에서 가져갈 관점
자기 개선의 출발점은 “모델을 더 오래 학습하자”보다 좋은 행동을 판별할 신호를 만들고, 그 신호가 계속 유효한지 확인하자에 가깝다. 검증 가능한 문제로 작은 순환을 만든 뒤, 정답의 빈도와 문제 해결 범위를 나누어 측정하고, 보상의 허점과 기존 능력의 저하도 확인하는 편이 좋다.
추론 계산을 늘려 얻은 성공을 학습에 돌리면 이후의 응답을 더 효율적으로 만들 수 있다. 다만 기초 모델의 능력, 데이터의 범위, 피드백의 신뢰성이 함께 받쳐 주어야 그 순환이 개선으로 이어진다.
출처 및 슬라이드 인용
· Stanford Online — CS329A Part 6: Train Time Scaling/Scaling RL
· Stanford CS329A 공식 강의 일정·읽기 자료
· Zelikman et al. — STaR: Bootstrapping Reasoning With Reasoning
· Shao et al. — DeepSeekMath
· Yu et al. — DAPO(강의 당시 판본)
슬라이드 이미지는 원본 강의 영상의 해당 화면을 발췌하고 각 그림 아래에 출처와 시점을 표기했다. 본문은 원문의 직역이 아닌 요약·해설이며, 일부 수치와 방법 설명은 원 논문으로 확인했다.
'AI Agent, LLM > Stanford CS329A Self Improving AI Agents' 카테고리의 다른 글
| [Stanford CS329A] 5강. 계획과 다단계 추론: LATS·SPRINT·SWiRL로 탐색하고 학습하기 (0) | 2026.11.16 |
|---|---|
| [Stanford CS329A] 4강. 도구와 피드백으로 배우기: ReAct·RLEF·Constitutional AI (0) | 2026.11.16 |
| [Stanford CS329A] 3강. 견고한 검증: ORM·PRM·Weaver로 정답을 고르는 법 (0) | 2026.11.12 |
| [Stanford CS329A] 2강. 추론 시 계산 확장: 반복 생성·검증·탐색으로 더 좋은 답 얻기 (0) | 2026.11.12 |
| [Stanford CS329A] 1강. LLM에서 자기 개선 AI 에이전트로: 스케일링·추론·검증 (0) | 2026.11.12 |