TL;DR
다단계 에이전트는 한 경로를 끝까지 따르기보다 행동의 결과를 평가하고 대안을 탐색하며 계획을 갱신해야 한다.
LATS는 트리 탐색으로 더 나은 실행 경로를 찾고, SPRINT는 독립적인 추론 단계를 병렬로 실행하도록 모델을 학습시킨다.
SWiRL은 미리 수집한 도구 사용 맥락과 단계별 AI 보상으로 다단계 행동을 개선하며, 성능·지연·총비용을 함께 평가하는 것이 중요하다.
Stanford CS329A: Self-Improving AI Agents의 5강은 “여러 번 생각하고 행동해야 하는 문제를 어떻게 더 잘, 더 효율적으로 해결할까?”를 다룬다. LATS·SPRINT·SWiRL을 통해 실행 중 탐색, 병렬 추론을 위한 지도 학습, 단계별 강화 학습을 차례로 살펴본다.
공식 강의 일정: 2025년 10월 6일 · 원본 영상
강의·영상 속 슬라이드·원 논문을 바탕으로 정리한 학습 노트다. 모델 비교와 실험 결과는 강의 당시의 연구 조건을 뜻한다.
1. 다단계 문제에서는 계획 자체도 수정 대상이다
여행 일정을 만든다고 해 보자. 예산과 목적지를 생각하는 것은 추론, 실제 숙소나 교통편을 검색하는 것은 행동이다. 검색 결과가 예산에 맞지 않으면 목적지와 경로를 다시 검토하는 탐색·계획 갱신이 필요하다. 처음 세운 계획을 그대로 수행하는 것만으로는 부족하다.
다단계 작업의 어려움은 앞의 실수가 뒤의 판단으로 이어진다는 점이다. 잘못된 검색어, 누락한 조건, 너무 이른 종료가 최종 실패로 번질 수 있다. 강의의 세 방법은 서로 다른 곳을 고친다. LATS는 지금 어떤 경로를 탐색할지, SPRINT는 어떤 추론을 함께 실행할지, SWiRL은 각 단계에서 어떤 행동을 하도록 배울지를 다룬다. [00:05–07:52]
2. LATS: 생각·행동·계획을 트리 탐색으로 묶는다
Language Agent Tree Search(LATS)는 ReAct의 환경 상호작용에 Monte Carlo Tree Search(MCTS)를 결합한다. 모델이 다음 행동 후보를 여러 개 제안하고, 실행 결과와 평가 점수를 바탕으로 유망한 경로를 더 탐색한다. 하나의 경로가 실패하더라도 그 경험을 다음 탐색에 활용할 수 있다.
- 선택: 현재 탐색 트리에서 확장할 노드를 고른다.
- 확장: 후보 행동을 생성·실행하고 환경의 관찰을 추가한다.
- 평가: 모델의 평가와 같은 행동이 반복 생성되는 정도를 결합해 상태의 가치를 추정한다.
- 시뮬레이션: 경로를 더 이어 가며 성공·실패 또는 예산 한도에 도달한다.
- 역전파: 실행 결과를 앞서 방문한 노드의 가치와 방문 횟수에 반영한다.
- 성찰: 실패·성공의 이유를 언어로 정리해 후속 탐색의 맥락에 넣는다.
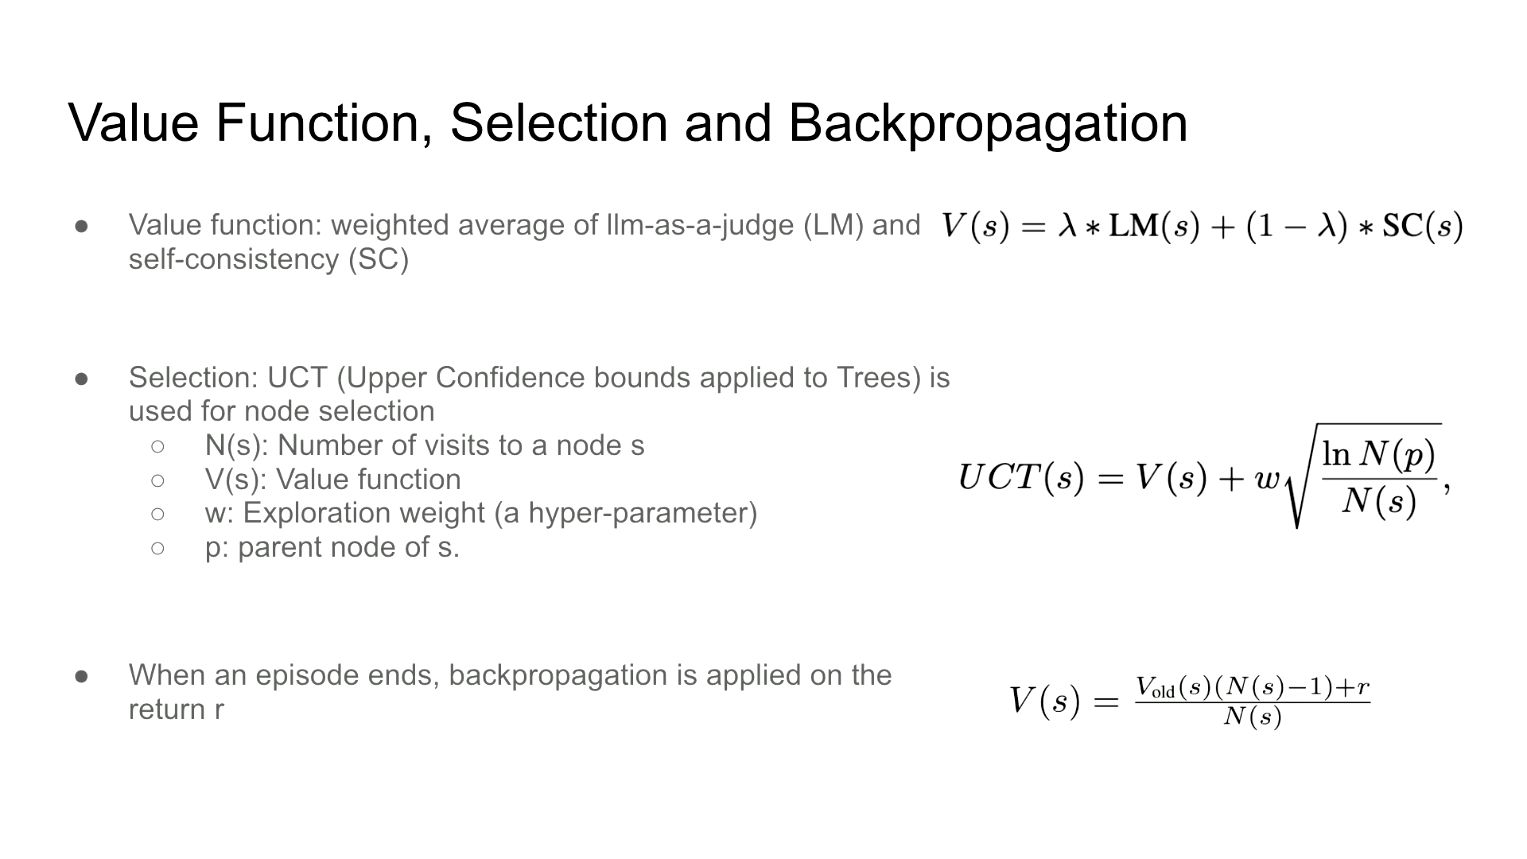
그림 1. 모델 평가와 self-consistency를 결합한 가치 함수, UCT에 따른 노드 선택, 실행 결과의 가치 갱신. 출처: Stanford CS329A 5강, 13:51. 원 연구: Zhou et al., LATS.
노드 선택에 쓰는 UCT는 현재 점수가 높은 경로를 활용하는 항과, 아직 덜 방문한 경로를 탐색하는 항을 더한다. 당장 점수가 낮아 보이는 대안도 살펴봐야 더 좋은 해결책을 발견할 수 있기 때문이다. 여기서 ‘역전파’는 탐색 트리의 점수를 갱신하는 것이며, 신경망 가중치를 학습시키는 gradient backpropagation과 구별해야 한다.
LATS는 추가 미세 조정 없이 추론 시 탐색으로 HotpotQA와 WebShop 등의 성능을 높였다. 다만 후보 생성·도구 실행·평가가 늘어나는 만큼 비싸다. 또한 경로를 되돌려 탐색한다는 가정이 결제나 메시지 발송처럼 되돌리기 어려운 실제 행동에 그대로 적용되지는 않는다. 분기를 시험할 수 있는 환경인지가 적용 조건이다. [07:57–20:31]
3. SPRINT: 긴 추론에서 독립적인 단계를 찾아 함께 실행한다
추론 모델이 더 오래 생각하면 어려운 문제의 정확도가 높아질 수 있지만, 모든 토큰을 순서대로 생성하면 답을 기다리는 시간도 길어진다. SPRINT의 관찰은 긴 추론 안에도 서로의 결과를 기다리지 않아도 되는 부분이 있다는 것이다. 독립적인 계산이나 하위 문제를 함께 실행할 수 있다면 전체 순차 경로를 줄일 수 있다.
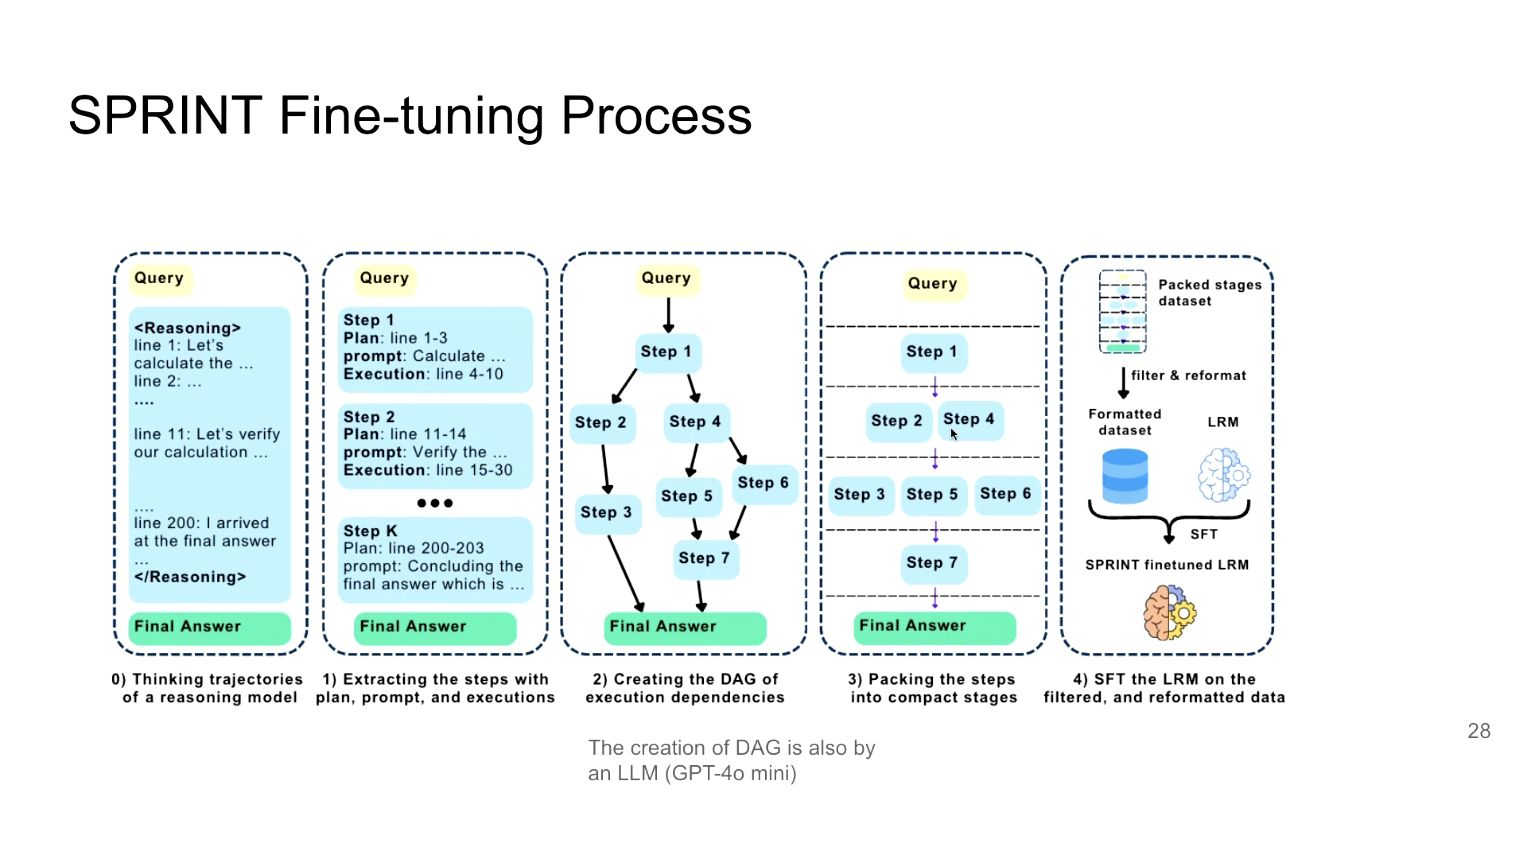
그림 2. 기존 추론을 계획·실행 단계로 나누고 의존성 DAG를 만들어, 함께 처리할 수 있는 단계를 묶는 SPRINT의 학습 데이터 구성. 출처: Stanford CS329A 5강, 30:00, 슬라이드 28. 원 연구: Biju et al., SPRINT.
학습 데이터는 다음처럼 만든다. 먼저 모델의 긴 풀이를 수집하고, 다른 LLM으로 각 부분을 계획과 실행으로 나눈다. 이어 단계 사이의 의존성을 DAG, 즉 순환이 없는 방향 그래프로 표현한다. 선행 결과가 필요 없는 단계끼리 묶고, 이 구조로 재구성한 데이터로 지도 미세 조정을 한다.
추론 시에는 모델이 함께 실행할 수 있는 계획들을 출력하고, 실행기들이 이를 병렬로 처리한다. 결과를 다시 맥락에 합친 뒤 다음 계획으로 넘어가는 순환을 반복한다. 문제 전체의 계획을 처음부터 전부 확정하는 방식은 아니다. 새 결과에 따라 이후 계획을 바꿀 수 있다. 모델 자체는 여전히 다음 토큰을 예측하며, 학습한 출력 구조와 실행 시스템이 병렬성을 활용한다. [23:29–36:26]
4. 병렬화의 성과는 총 토큰 절감과 같은 뜻이 아니다
SPRINT는 수학 추론에서 지도 학습을 했는데도 GPQA와 Countdown 같은 다른 과제에서 효과를 보였다. 강의는 더 구조화된 계획·실행이 병렬화 기회뿐 아니라 정확도에도 도움이 되는 결과를 소개한다.
논문에서 보고한 대표 결과는 긴 수학 풀이, 특히 8,000개를 넘는 출력 토큰이 필요한 문제에서 순차 토큰 수를 최대 약 39% 줄이면서 비교 모델의 성능을 유지한 것이다. 이는 모든 요청에서 총 생성 토큰이나 비용이 39% 줄었다는 의미가 아니다. 실제 응답 시간은 병렬 실행에 쓸 자원, 실행기 사이의 부하 차이, 결과를 합치는 비용에도 달려 있다.
짧고 쉬운 문제에는 계획을 나누는 추가 작업이 오히려 부담이 될 수 있다. 독립적인 부분이 적거나 한 분기가 유독 오래 걸리는 경우에도 이득이 줄어든다. 따라서 정확도·전체 작업량·가장 긴 순차 경로·실제 응답 시간을 따로 기록해야 한다. 강의도 실제 wall-clock 가속과 도구 병렬화의 구현을 후속 과제로 제시한다. [36:30–50:22]
5. SWiRL: 도구 실행을 미리 모으고, 각 단계의 행동을 개선한다
Step-Wise Reinforcement Learning(SWiRL)은 다단계 도구 사용을 학습하는 방법이다. 모델은 도구를 언제 부를지, 어떤 입력을 보낼지, 관찰한 결과를 어떻게 이어 쓸지, 언제 답변을 끝낼지를 배워야 한다. 그런데 강화 학습 과정마다 검색이나 코드 실행을 실제로 수행하면 지연·실패·비용이 학습을 방해한다.
SWiRL은 이 부담을 두 단계로 나눈다.
- 다단계 데이터 수집: 모델에게 추론·도구 호출·최종 답변 중 다음 행동을 선택하게 한다. 도구를 실제 실행해 결과를 맥락에 넣고, 이를 반복해 여러 단계의 합성 궤적을 만든다. AI 평가자로 단계의 품질도 평가한다.
- 단계별 강화 학습: 미리 수집한 이전 단계와 관찰을 주고, 모델이 새로 제안한 다음 행동의 품질에 보상을 준다. 이 학습 중에는 새 행동의 도구를 매번 실행하지 않는다.
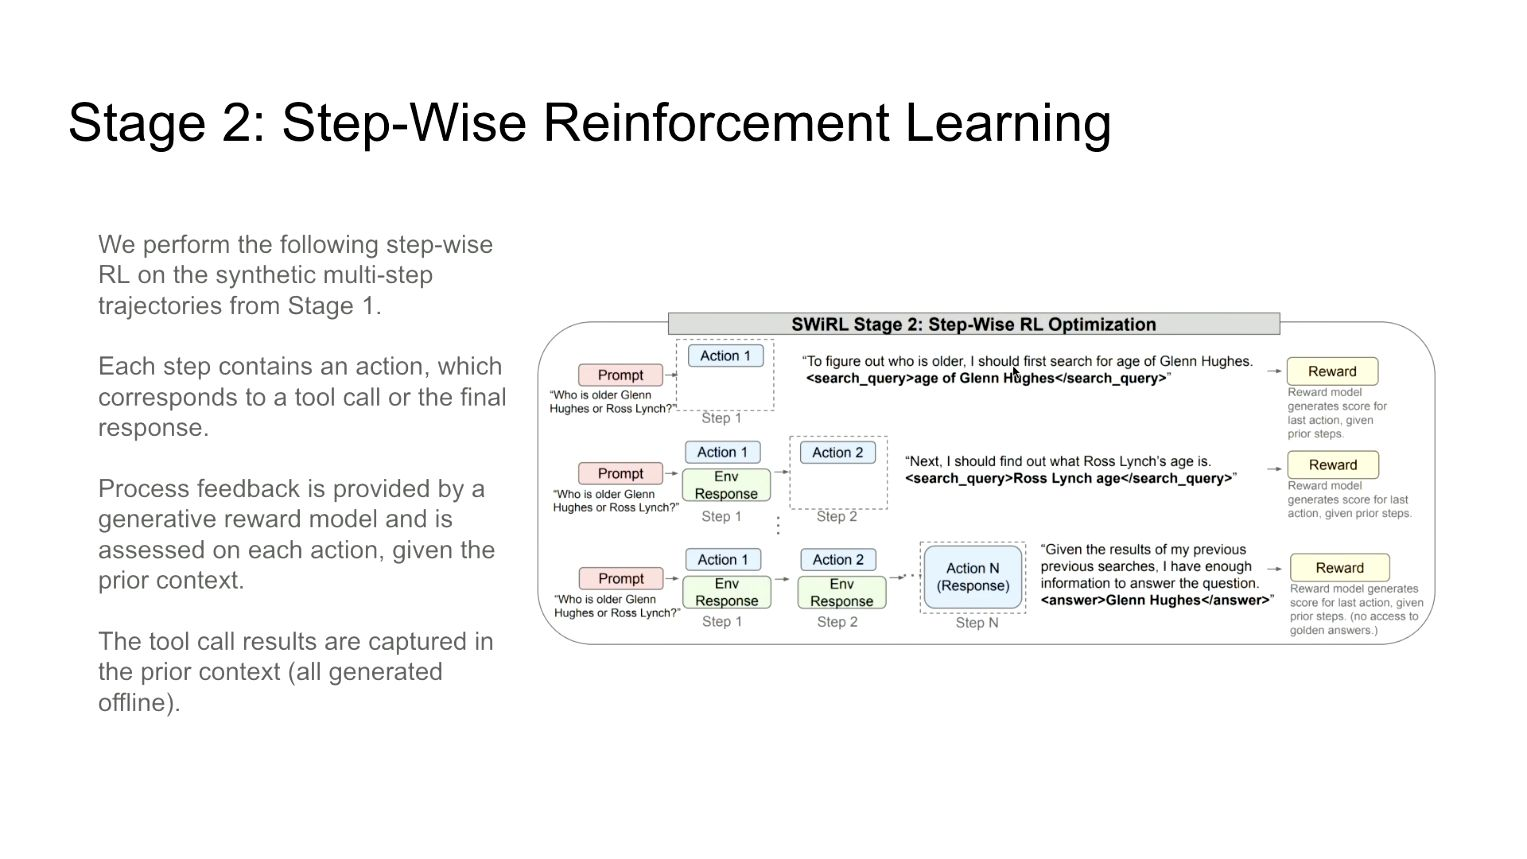
그림 3. 이전 행동과 환경 응답을 맥락으로 제공하고, 새 행동을 단계별 보상으로 학습하는 SWiRL. 출처: Stanford CS329A 5강, 59:29. 원 연구: Goldie et al., SWiRL.
예를 들어 두 사람 중 누가 더 나이가 많은지 묻는다면, 평가자는 ‘첫 번째 사람의 나이를 검색한다’는 호출이 질문 해결에 적절한지 판단할 수 있다. 그 호출의 실제 검색 결과를 새로 받아야만 호출 자체의 품질을 평가할 수 있는 것은 아니다. 실행 성공을 직접 확인하는 보상과, 다음 행동이 합리적인지 평가하는 보상은 다른 신호다.
따라서 ‘도구 없이 학습한다’는 표현은 전체 절차에 도구가 없다는 뜻이 아니다. 데이터 수집 단계에는 실제 도구 호출이 있고, 배포 후 추론에서도 도구를 실행한다. 느린 도구 실행을 RL 최적화의 내부 반복에서 분리한 것이 핵심이다. [50:25–1:06:09]
6. 과정이 좋은 데이터와 최종 답이 맞는 데이터는 다르다
SWiRL은 합성 데이터를 필터링하는 기준도 비교한다. 과정 기준은 각 단계의 행동이 좋은지, 결과 기준은 최종 답이 맞는지를 본다. 실험에서는 단계별 RL에 과정 기준으로 고른 데이터가 유리했다. 최종 답이 틀렸더라도 중간에 유용한 검색과 추론이 있을 수 있고, RL은 그 맥락에서 새로운 행동을 시도할 기회를 주기 때문이다.
반대로 지도 미세 조정은 주어진 응답을 그대로 따라 하도록 학습하므로, 과정과 결과가 함께 올바른 데이터가 더 유리했다. ‘틀린 답도 학습에 넣으면 좋다’는 일반 법칙이 아니라, 학습 목적에 따라 좋은 데이터의 조건이 달라진다는 결과다.
또한 검색을 사용하는 질문 답변으로 학습한 뒤 계산 도구를 사용하는 수학 문제에서 개선되고, 반대 방향으로도 전이되는 결과가 나타났다. 특정 도구의 사용법만 외우는 것 이상으로 단계적 문제 해결을 배울 가능성을 보여 준다. 다만 이는 제시된 모델·도구·벤치마크에서의 전이이며, 임의의 새 도구에 자동으로 적응한다는 보장은 아니다. AI 평가자의 오류도 단계별 보상에 그대로 영향을 줄 수 있다. [1:06:16–1:14:38]
이 강의에서 가져갈 관점
| 방법 | 바꾸는 것 | 주요 부담 |
| LATS | 추론 중 탐색할 행동 경로 | 추가 호출·평가 비용과 환경의 되돌리기 가능성 |
| SPRINT | 계획·실행 구조를 배우고 독립 단계를 병렬 실행 | 의존성 판단, 병렬 자원, 동기화와 부하 차이 |
| SWiRL | 이전 맥락에서 다음 행동을 고르는 정책 | 합성 데이터와 AI 보상의 품질 |
더 오래 생각하게 만드는 것에서 한 걸음 더 나아가, 어디를 탐색하고, 무엇을 동시에 실행하고, 어떤 행동을 배울지를 설계해야 한다. 실행 중 탐색과 모델 학습은 함께 쓸 수 있지만 성과의 원인은 구분해서 평가한다. 성공률이 올랐더라도 호출·학습·실행 비용을 합친 개선인지, 실제 대기 시간이 줄었는지까지 확인해야 쓸 만한 다단계 에이전트가 된다.
출처 및 슬라이드 인용
· Stanford Online — CS329A Part 5: Planning and Multi-Step Reasoning
· Stanford CS329A 공식 강의 일정·읽기 자료
· Zhou et al. — Language Agent Tree Search Unifies Reasoning Acting and Planning in Language Models
· Biju et al. — SPRINT: Enabling Interleaved Planning and Parallelized Execution in Reasoning Models
· Goldie et al. — Synthetic Data Generation & Multi-Step RL for Reasoning & Tool Use
슬라이드 이미지는 원본 강의 영상의 해당 화면을 발췌하고 각 그림 아래에 출처와 시점을 표기했다. 본문은 원문의 직역이 아닌 요약·해설이다.
'AI Agent, LLM > Stanford CS329A Self Improving AI Agents' 카테고리의 다른 글
| [Stanford CS329A] 6강. 학습 시 계산 확장: STaR·GRPO·DAPO로 자기 개선 순환 만들기 (0) | 2026.11.16 |
|---|---|
| [Stanford CS329A] 4강. 도구와 피드백으로 배우기: ReAct·RLEF·Constitutional AI (0) | 2026.11.16 |
| [Stanford CS329A] 3강. 견고한 검증: ORM·PRM·Weaver로 정답을 고르는 법 (0) | 2026.11.12 |
| [Stanford CS329A] 2강. 추론 시 계산 확장: 반복 생성·검증·탐색으로 더 좋은 답 얻기 (0) | 2026.11.12 |
| [Stanford CS329A] 1강. LLM에서 자기 개선 AI 에이전트로: 스케일링·추론·검증 (0) | 2026.11.12 |